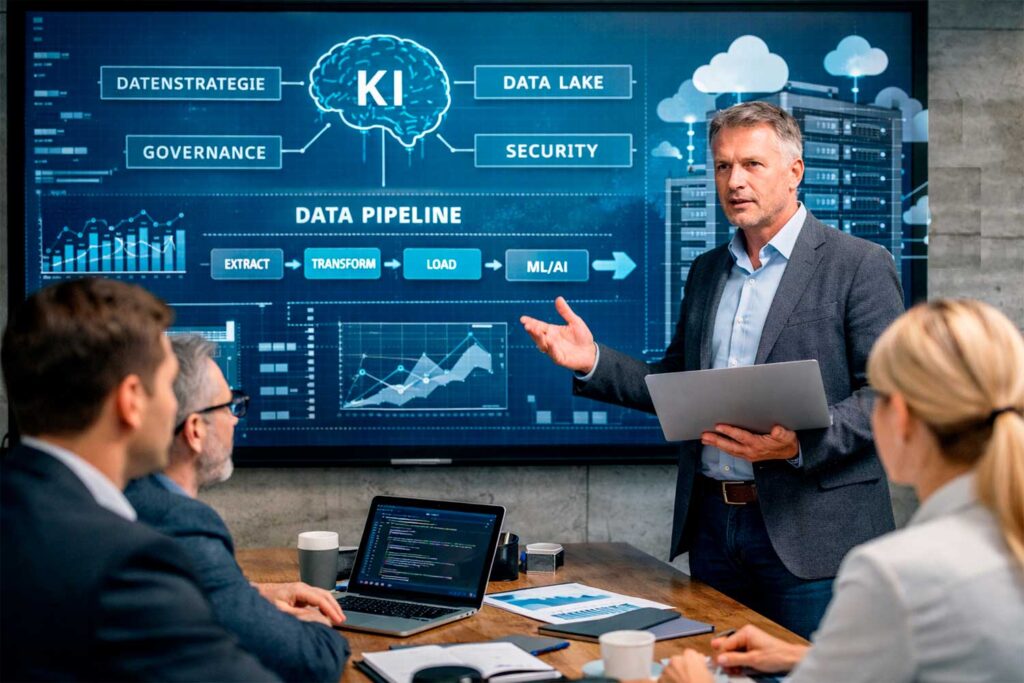
KI wird nur dann zum Wettbewerbsvorteil, wenn Ihre Dateninfrastruktur verlässlich liefert. Wer heute KI-Projekte startet, ohne Datenstrategie, Governance und skalierbare Plattform, produziert teure Prototypen statt messbarer Ergebnisse.
Entscheider-Perspektive: Was „KI-ready“ in der Praxis bedeutet
KI-ready heißt nicht „mehr Daten sammeln“. KI-ready heißt: Daten sind auffindbar, nutzbar, geschützt, aktuell und kostenbewusst bereitgestellt – über Fachbereiche hinweg.
Kernmerkmale einer KI-tauglichen Datenbasis:
- Verfügbarkeit: Relevante Datenquellen sind angebunden, Zugriffe sind geregelt.
- Verständlichkeit: Begriffe, KPIs und Datenmodelle sind dokumentiert.
- Verlässlichkeit: Qualität, Aktualität, Lineage und Verantwortlichkeiten sind klar.
- Skalierbarkeit: Compute/Storage wachsen mit Use Cases – ohne Architekturbruch.
- Sicherheit: Rollen, Protokolle, Verschlüsselung, Datenschutz sind Standard.
- Wirtschaftlichkeit: Kosten pro Use Case sind transparent und steuerbar.
Business-Startpunkt: Erst Werthebel, dann Architektur
Werthebel gehören vor Technologieentscheidungen. Wenn Sie die Infrastruktur „ins Blaue“ modernisieren, verlieren Sie Zeit und Akzeptanz. Besser: Use Cases priorisieren, daraus Daten- und Plattformanforderungen ableiten.
Typische KI-Use-Case-Cluster für Führungskräfte:
- Umsatz: Next-Best-Offer, dynamische Preise, Lead-Scoring
- Effizienz: Automatisierte Dokumentenverarbeitung, Ticket-Routing, Forecasting
- Risiko: Betrugserkennung, Anomalien, Compliance-Checks
- Service: Self-Service-Analytik, Wissensassistenz, Chat- & Voice-Bots (RAG)
- Produktion: Predictive Maintenance, Qualitätsprüfung, OEE-Optimierung
Entscheidungsregel: Starten Sie mit 3–5 Use Cases, die (a) Datenzugang haben, (b) ROI in 90–180 Tagen zeigen können, (c) organisatorisch tragfähig sind.
Dateninventur: Ohne Transparenz keine Geschwindigkeit
Transparenz ist der schnellste Hebel. Viele Unternehmen scheitern nicht an „fehlenden Daten“, sondern an „unbekannten Daten“.
Sofort wirksame Schritte einer Dateninventur:
- Quellenliste: ERP/CRM, Webtracking, Tickets, IoT, DWH, Data Lake, Files, SaaS
- Dateneigner: Pro Domäne eine fachliche und eine technische Verantwortung
- Datenflüsse: Welche Pipelines liefern welche Tabellen/Events – in welcher Frequenz?
- Qualität: Vollständigkeit, Plausibilität, Dubletten, Timeliness, Ausreißer
- Zugriffe: Wer nutzt was – und wofür? (Kosten- und Sicherheitshebel)
- Lücken: Fehlende IDs, fehlende Historisierung, fehlende Stammdatenlogik
Pragmatischer Output: Ein „Data Product Backlog“ mit priorisierten Datenprodukten statt eines monatelangen Analyseprojekts.
Zielarchitektur: Lakehouse, Data Mesh oder klassisches DWH?
Zielarchitektur muss Ihre Realität abbilden: Teams, Skillset, Regulatorik, Time-to-Value. Es gibt kein Dogma – aber es gibt klare Muster.
Lakehouse (Data Lake + Warehouse-Qualitäten):
- Stärken: Einheitliche Plattform, gute Skalierung, geeignet für BI + ML/AI
- Risiken: Ohne Governance wird es zum „Data Swamp“
- Passt gut: Wenn Sie viele Datentypen (strukturiert/unstrukturiert) integrieren
Data Mesh (Domänenverantwortung, „Daten als Produkt“):
- Stärken: Ownership, Geschwindigkeit, Nähe zum Fachbereich
- Risiken: Hohe Anforderungen an Standards, Plattformteam, Data Product Thinking
- Passt gut: Wenn Sie mehrere starke Domänenteams und viele Datenprodukte haben
Klassisches DWH (stark modelliert, kuratiert):
- Stärken: Stabilität, Konsistenz, Reporting-Exzellenz
- Risiken: Langsamere Änderungen, unstrukturierte Daten schwerer integrierbar
- Passt gut: Wenn BI-Konsistenz oberste Priorität hat und KI ergänzend ist
Entscheider-Kriterium: Wählen Sie das Modell, das Ihre Organisation zuverlässig betreiben kann – nicht das, das am modernsten klingt.
Datenpipelines: Qualität entsteht nicht im Dashboard
Datenpipelines sind die Produktionsstraße Ihrer KI. Wenn hier Fehler passieren, werden Modelle und Assistenten unzuverlässig – und Nutzer verlieren Vertrauen.
Bewährte Pipeline-Prinzipien:
- ELT/ETL-Standard: Klare Regeln, wann transformiert wird und wo
- Testbarkeit: Automatisierte Checks auf Schema, Nullwerte, Schlüssel, Ausreißer
- Beobachtbarkeit: Monitoring für Laufzeiten, Volumen, Freshness, Fehlerquoten
- Versionierung: Datenmodelle und Transformationen gehören in Git + CI/CD
- Wiederholbarkeit: Reproduzierbare Runs, klare Backfill-Strategien
- Ereignisfähigkeit: Wo nötig, Streaming/CDC statt nächtlicher Batch-Magie
Konsequenz: „Data Reliability“ wird zur KPI – ähnlich wie Uptime in der IT.
Metadaten & Katalog: KI braucht Kontext, nicht nur Tabellen
Kontext entscheidet über Nutzbarkeit. KI-Systeme – besonders LLM-gestützte Anwendungen – profitieren massiv von sauberem Metadatenmanagement.
Elemente, die sich schnell auszahlen:
- Datenkatalog: Auffindbarkeit, Beschreibung, Verantwortliche, Nutzungszweck
- Business-Glossar: Einheitliche Definitionen von KPIs (z. B. „Aktiver Kunde“)
- Lineage: Herkunft und Transformationen – wichtig für Vertrauen und Audits
- Klassifizierung: Sensitivität, PII, Aufbewahrung, Zugriffsklassen
Praxisregel: Lieber 20 geschäftskritische Datenprodukte exzellent dokumentieren als 2.000 Tabellen halbherzig.
Governance & Sicherheit: KI skaliert nur mit klaren Leitplanken
Leitplanken reduzieren Risiko und beschleunigen Entscheidungen. Gerade Entscheider unterschätzen: KI verstärkt Datenrisiken (falsche Antworten, Leaks, Bias, Compliance-Verstöße).
Minimum-Standard für KI-fähige Governance:
- Rollenmodell: Least Privilege, klare Freigabeprozesse, nachvollziehbare Zugriffe
- Datenschutz: DSGVO-konforme Verarbeitung, Zweckbindung, Löschkonzepte
- Maskierung: Tokenisierung/Anonymisierung für Trainings- und Testumgebungen
- Auditability: Protokollierung, Nachvollziehbarkeit von Daten- und Modellnutzung
- Policy-by-Design: Sicherheitsregeln direkt in Plattform und Pipelines verankern
Executive-Ansatz: Governance als Produkt verstehen – mit Service-Levels und klaren Ansprechpartnern.
KI-spezifische Bausteine: Feature Store, Vektordatenbank, LLMOps
KI-Bausteine hängen vom Use Case ab. Für viele Unternehmen sind diese drei Komponenten entscheidend, sobald KI produktiv wird:
Feature Store (für klassische ML-Modelle):
- Nutzen: Einheitliche Features, Wiederverwendung, Konsistenz zwischen Training und Inferenz
- Voraussetzung: Saubere Entitäten, Historisierung, definierte Feature-Pipelines
Vektordatenbank (für RAG/semantische Suche):
- Nutzen: Schnelles Retrieval von Textpassagen, Dokumenten, Wissen
- Voraussetzung: Gute Dokumentenstruktur, Chunking-Strategie, Metadaten-Tags
LLMOps/MLOps (für Betrieb & Qualität):
- Nutzen: Versionskontrolle, Freigaben, Monitoring, Rollback, Prompt-/Modellevaluation
- Voraussetzung: Klare Qualitätsmetriken (Accuracy, Hallucination-Rate, Latency, Cost)
Wichtiges Detail: Ohne Monitoring und Evaluation wird ein KI-Assistent zur Blackbox – und endet oft als „Pilot ohne Zukunft“.
Datenqualität: Der unterschätzte ROI-Hebel
Datenqualität ist kein Schönheitsprojekt. Sie ist direkte Wertschöpfung: weniger manuelle Korrekturen, weniger Fehlentscheidungen, höhere Automatisierungsquote.
Qualitätsmaßnahmen, die Führungskräfte sofort priorisieren können:
- Golden Records: Stammdaten konsolidieren (Kunde, Produkt, Standort)
- Schlüsselstrategien: Eindeutige IDs, stabile Referenzen, saubere Historien
- Validierungsregeln: Fachlogik in Tests gießen (z. B. „Rechnungsbetrag ≥ 0“)
- Datenverträge: Produzenten/Consumer vereinbaren Schema, Frequenz, SLAs
- Quality Ownership: Fehler nicht „an die BI“ delegieren, sondern domänenseitig lösen
Messbar machen: Cost-of-Poor-Data-Quality (Zeit, Fehlbuchungen, Retouren, Eskalationen).
Infrastrukturentscheidungen: Cloud, Hybrid, On-Prem – aber richtig begründet
Begründung ist entscheidend. KI-Workloads sind ressourcenintensiv und variabel. Eine falsche Infrastrukturentscheidung erzeugt entweder Sicherheitsrisiken oder unnötige Kosten.
Cloud eignet sich häufig, wenn:
- Skalierung: Lastspitzen, GPU/Compute-Bedarf, schnelle Experimente relevant sind
- Time-to-Value: Teams schnell starten sollen, ohne Hardware-Beschaffung
- Ökosystem: Managed Services (Daten, ML, Observability) genutzt werden sollen
Hybrid/On-Prem ist sinnvoll, wenn:
- Regulatorik: Strenge Vorgaben, Datenresidenz, spezielle Audit-Anforderungen
- Latenz: Echtzeitnahe Produktionssysteme gekoppelt werden müssen
- Legacy: Kritische Systeme nicht kurzfristig migrierbar sind
Kostensteuerung braucht:
- Workload-Trennung: Dev/Test/Prod strikt separieren
- FinOps: Budgets, Tags, Chargeback/Showback, Nutzungsreporting
- Standardisierung: Weniger Tool-Wildwuchs, klare Plattformprodukte
Roadmap: In 90 Tagen von Chaos zu Struktur
Roadmap sorgt für Geschwindigkeit und Governance zugleich. Eine sinnvolle Taktung verhindert Stillstand und vermeidet den „Big Bang“.
Phase 1: 0–30 Tage – Fundament
- Use Cases priorisieren und Erfolgskriterien definieren
- Dateninventur starten (Top-Quellen, Top-Datenprodukte)
- Zugriffsmodell und PII-Klassifizierung festlegen
- Plattformbaseline definieren (Lakehouse/DWH/Hybrid) samt Betriebskonzept
Phase 2: 31–60 Tage – Lieferfähigkeit
- Kernpipelines für 2–3 Use Cases bauen (inkl. Tests & Monitoring)
- Katalog/Glossar für kritische KPIs aufsetzen
- Qualitätsregeln implementieren und Ownership etablieren
- Security (IAM, Verschlüsselung, Logging) produktionsnah durchziehen
Phase 3: 61–90 Tage – KI-Readiness
- Data Products mit SLAs veröffentlichen
- RAG/LLM-Pilot oder ML-Pilot produktionsnah testen (inkl. Evaluation)
- MLOps/LLMOps minimal einführen (Versionierung, Deployment, Monitoring)
- Executive Dashboard für Wertbeitrag, Risiken, Kosten etablieren
Ergebnis: Sie erhalten eine Plattform, die nicht nur Daten sammelt, sondern KI-Projekte reproduzierbar in Produktion bringt.
Häufige Fehler: Was KI-Initiativen unnötig ausbremst
Fehlerbilder wiederholen sich:
- Tool-Fokus: Erst Software kaufen, dann nach Use Cases suchen
- Schatten-IT: Isolierte Piloten ohne Security, Governance und Betrieb
- Daten-Silos: Domänen arbeiten getrennt, KPIs widersprechen sich
- Qualitätsignoranz: Modelle kompensieren schlechte Daten nicht dauerhaft
- Betriebsblindheit: Kein Monitoring, keine Kostenkontrolle, kein Rollback
Gegenmittel: Klare Verantwortlichkeiten, Data Products, Standards, Messbarkeit.
Checkliste für Entscheider: Sind wir wirklich KI-bereit?
Strategie
- Use Cases priorisiert, ROI-Logik definiert, Sponsor benannt
- KPIs einheitlich definiert, Business Glossar vorhanden
Daten
- Inventur der wichtigsten Quellen abgeschlossen
- Ownership und SLAs für kritische Datenprodukte festgelegt
- Qualität messbar, automatisiert geprüft, transparent berichtet
Plattform
- Zielarchitektur gewählt und betrieblich abgesichert
- Pipelines versioniert, getestet, überwacht
- Metadaten (Katalog, Lineage, Klassifizierung) etabliert
Security & Compliance
- IAM und Least Privilege umgesetzt
- DSGVO-Mechanismen integriert (PII, Zweckbindung, Löschung)
- Auditfähigkeit durch Logging und Prozesse gegeben
KI-Betrieb
- MLOps/LLMOps minimal vorhanden
- Evaluation und Monitoring für Qualität, Kosten, Latenz definiert
Schlussgedanke: Dateninfrastruktur ist Ihr KI-Betriebssystem
KI-Programme scheitern selten an Modellqualität – sie scheitern an Datenrealität. Wenn Sie Datenstrategie, Plattform und Governance zusammen denken, entsteht ein System, das Innovation ermöglicht und Risiken kontrolliert. Genau das erwarten Führungskräfte: planbare Ergebnisse statt Experimente.
Wenn Sie Ihre Dateninfrastruktur KI-ready machen wollen, ohne interne Teams zu überlasten, unterstützen wir Sie als Agentur für Webentwicklung bei Konzeption, Umsetzung und Integration: von Datenplattform-Frontends und Self-Service-Portalen bis zu sicheren Schnittstellen, Workflows und produktionsreifen KI-Anwendungen. Fordern Sie jetzt ein unverbindliches Angebot an – wir prüfen Ihre Ausgangslage, priorisieren Werthebel und skizzieren eine umsetzbare Roadmap, die zu Ihrem Geschäft passt.